 نیازمند استعلام
DL384 Gen12
HPE ProLiant DL384 Gen12
معرفی و مشخصات DL384 Gen12
بررسی تخصصی سرور HPE ProLiant DL384 Gen12
نسل جدید محاسبات برای هوش مصنوعی، HPC و پردازشهای LLM
در دوران انفجار داده و گسترش مدلهای زبانی بزرگ (LLM) و کاربردهای پیچیدهی هوش مصنوعی، نیاز به زیرساختهایی با توان محاسباتی فوقالعاده، مصرف بهینه و معماری مدرن بیش از پیش احساس میشود.
HPE ProLiant DL384 Gen12 پاسخی مستقیم به این نیاز است — یک سرور مبتنی بر سوپرچیپهای ترکیبی CPU-GPU NVIDIA GH200 Grace Hopper که از پایه برای بارهای کاری AI، یادگیری عمیق و inference در سطح دیتاسنتر طراحی شده است.
🎯 چرا DL384 Gen12 با GH200 یک سرور عادی نیست؟
✅ طراحی مبتنی بر Superchip بهجای CPU+GPU سنتی
در گذشته، سرورهای GPU معمولاً ترکیبی از پردازندههای Xeon و کارتهای گرافیکی NVIDIA مانند H100 بودند. اما DL384 Gen12 با بهرهگیری از GH200 Grace Hopper Superchip این ساختار را کاملاً بازطراحی کرده است.
GH200 چیست؟
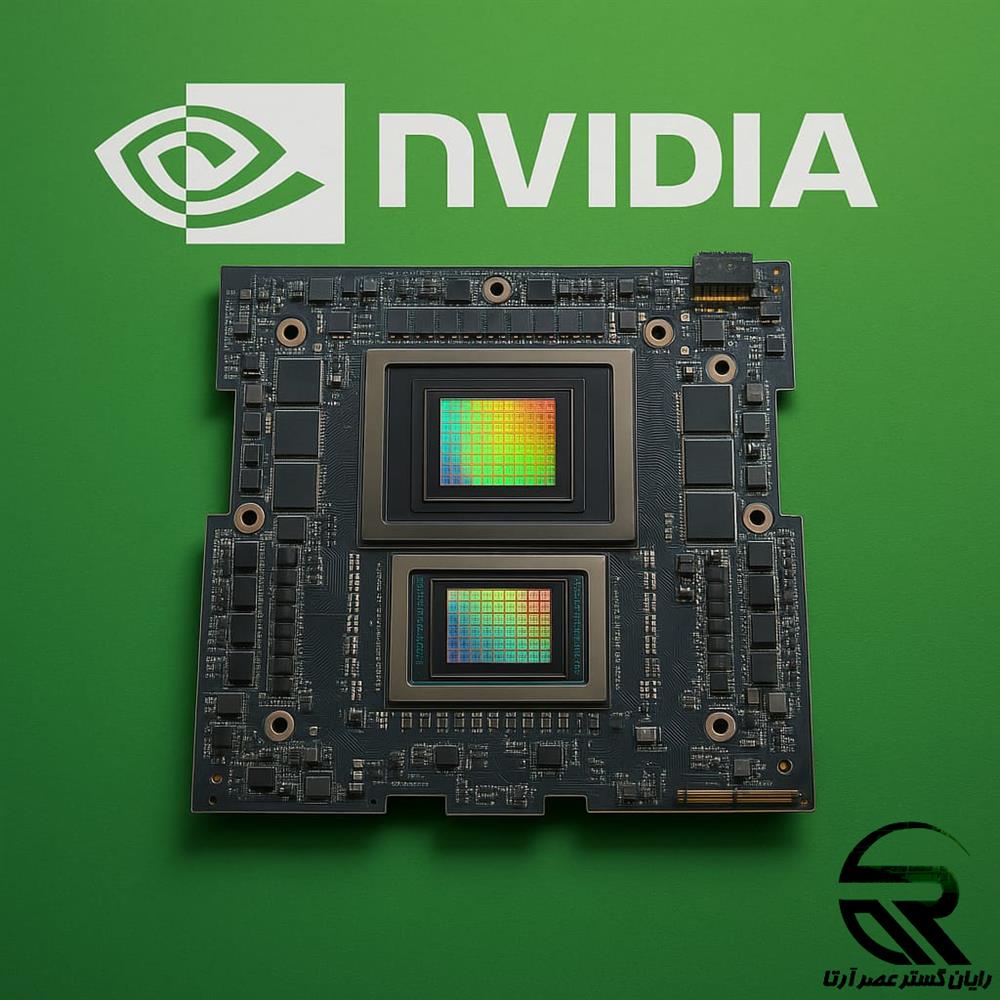
سوپرچیپ GH200 ترکیبی از پردازنده 72 هستهای ARM Grace و شتابدهنده Hopper در یک پکیج سیلیکونی است. این دو بخش با NVLink-C2C بههم متصل شدهاند، که پهنای باند بسیار بالاتر از PCIe فراهم میکند و تأخیرهای سیستم سنتی را حذف میکند.
🚀 مزایای کلیدی GH200 نسبت به معماریهای سنتی:
-
تجمیع واقعی CPU و GPU در یک چیپ باعث کاهش تأخیر، افزایش بازده پردازشی، و کاهش مصرف انرژی میشود.
-
کارایی خارقالعاده در پردازشهای AI: بهویژه در آموزش و استنتاج مدلهای بزرگ مانند ChatGPT، Gemini، Claude و مدلهای چندزبانه.
-
حافظه پرسرعت HBM3e باعث میشود bottleneck حافظه در مدلهای با پارامتر بالا بهطور کامل رفع شود.
-
پشتیبانی از پلتفرم NVIDIA NVL2 که امکان اتصال دو GH200 از طریق NVLink-C2C و به اشتراکگذاری حافظه را فراهم میکند.
🧠 چرا GH200 برای LLM و GenAI ایدهآل است؟
در آموزش مدلهای LLM (مانند GPT، BERT یا LLaMA)، حجم ورودیها و پارامترها بسیار بالاست. نیاز به حافظه با پهنای باند بالا، قدرت پردازش عددی در سطح ترافلاپ، و ارتباط سریع بین CPU و GPU حیاتی است. GH200 این الزامات را با تجمیع حافظه HBM3e، پردازندههای قدرتمند ARM Grace، و Tensor Coreهای نسل Hopper بهصورت یکپارچه تأمین میکند.
🔄 پیکربندیهای قابل پشتیبانی در DL384 Gen12
حالت تک سوپرچیپ:
-
یک عدد GH200 با 96GB حافظه HBM3e با پهنای باند بسیار بالا
-
مناسب برای پروژههای inference و بارهای AI مقیاس متوسط
حالت دو سوپرچیپ (NVL2):
-
دو عدد GH200 بهصورت مستقیم متصل از طریق NVLink-C2C
-
دسترسی اشتراکی به حافظه HBM بین دو تراشه
-
عملکرد دو برابر با حفظ کارایی حرارتی و مصرف انرژی
-
مناسب برای آموزش مدلهای LLM، دیتابیسهای بردارمحور، bioinformatics و هوش مصنوعی مقیاس بزرگ
| ویژگی | پیکربندی تک GH200 | پیکربندی دو GH200 (NVL2) |
|---|---|---|
| هسته CPU | 72 ARMv9 | 2×72 ARMv9 |
| حافظه HBM | 96GB | 192GB |
| NVLink داخلی | ندارد | دارد (NVLink-C2C) |
| کارایی AI | سطح بالا | تا 2 برابر H100 ✅ |
| پهنای باند حافظه | ~450GB/s | ~900GB/s |
💡 قابلیتهای کلیدی DL384 Gen12
-
✔️ پشتیبانی کامل از دو عدد GH200 NVL2 Superchip
-
✔️ معماری پیشرفته برای محاسبات AI-native
-
✔️ اسلاتهای PCIe Gen5 با پشتیبانی از NVIDIA BlueField و InfiniBand
-
✔️ طراحی ماژولار برای افزودن NVMe، OCP و کارتهای شبکه پرسرعت
-
✔️ گواهی NVIDIA OVX برای اجرای بارهای گرافی سنگین و LLM
🔐 امنیت در کلاس Enterprise
DL384 Gen12 از HPE Silicon Root of Trust بهره میبرد؛ مکانیزم امنیتی مبتنی بر معماری Zero Trust که از لایه سختافزار تا سیستمعامل و نرمافزار، محیط شما را در برابر تهدیدات محافظت میکند.
☁️ تجربه ابری در دیتاسنتر با HPE GreenLake
این سرور بهصورت کامل با پلتفرم HPE GreenLake سازگار است. شما میتوانید آن را در قالب "پرداخت بهازای مصرف" در محل خود یا کلوکیشن پیادهسازی کرده و همزمان تجربهی ابری را در کنار امنیت زیرساخت فیزیکی داشته باشید.
🧠 نتیجهگیری: پلتفرم آمادهی آینده
HPE DL384 Gen12 تنها یک سرور نیست؛ بلکه یک معماری بازتعریفشده برای دنیای پردازشهای سنگین آینده است. اگر به دنبال راهکاری برای افزایش بازده مدلهای زبانی، تسریع inference و آموزش مدلهای هوش مصنوعی در مقیاس سازمانی هستید، این سرور یکی از هوشمندانهترین انتخابهاست.
مشاوره تخصصی پیش از خرید
کارشناسان رایان گستر برای بررسی سازگاری، پیکربندی و انتخاب دقیق تجهیزات همراه شما هستند.